디자인 판단
질문
화면은 멀쩡해 보여도 실제 사용에서 틀릴 수 있다. 그러면 무엇을 보고 틀렸다고 판단하는가.
이 질문은 프로젝트마다 다시 나왔다. 아래 여섯 개에는 내 판단을 반박한 근거와 그 뒤에 바꾼 것을 적었다. 숫자는 각 프로젝트 페이지와 같다.
01. 리뷰를 통과한 기능 12종이 한 화면에서 무너졌다
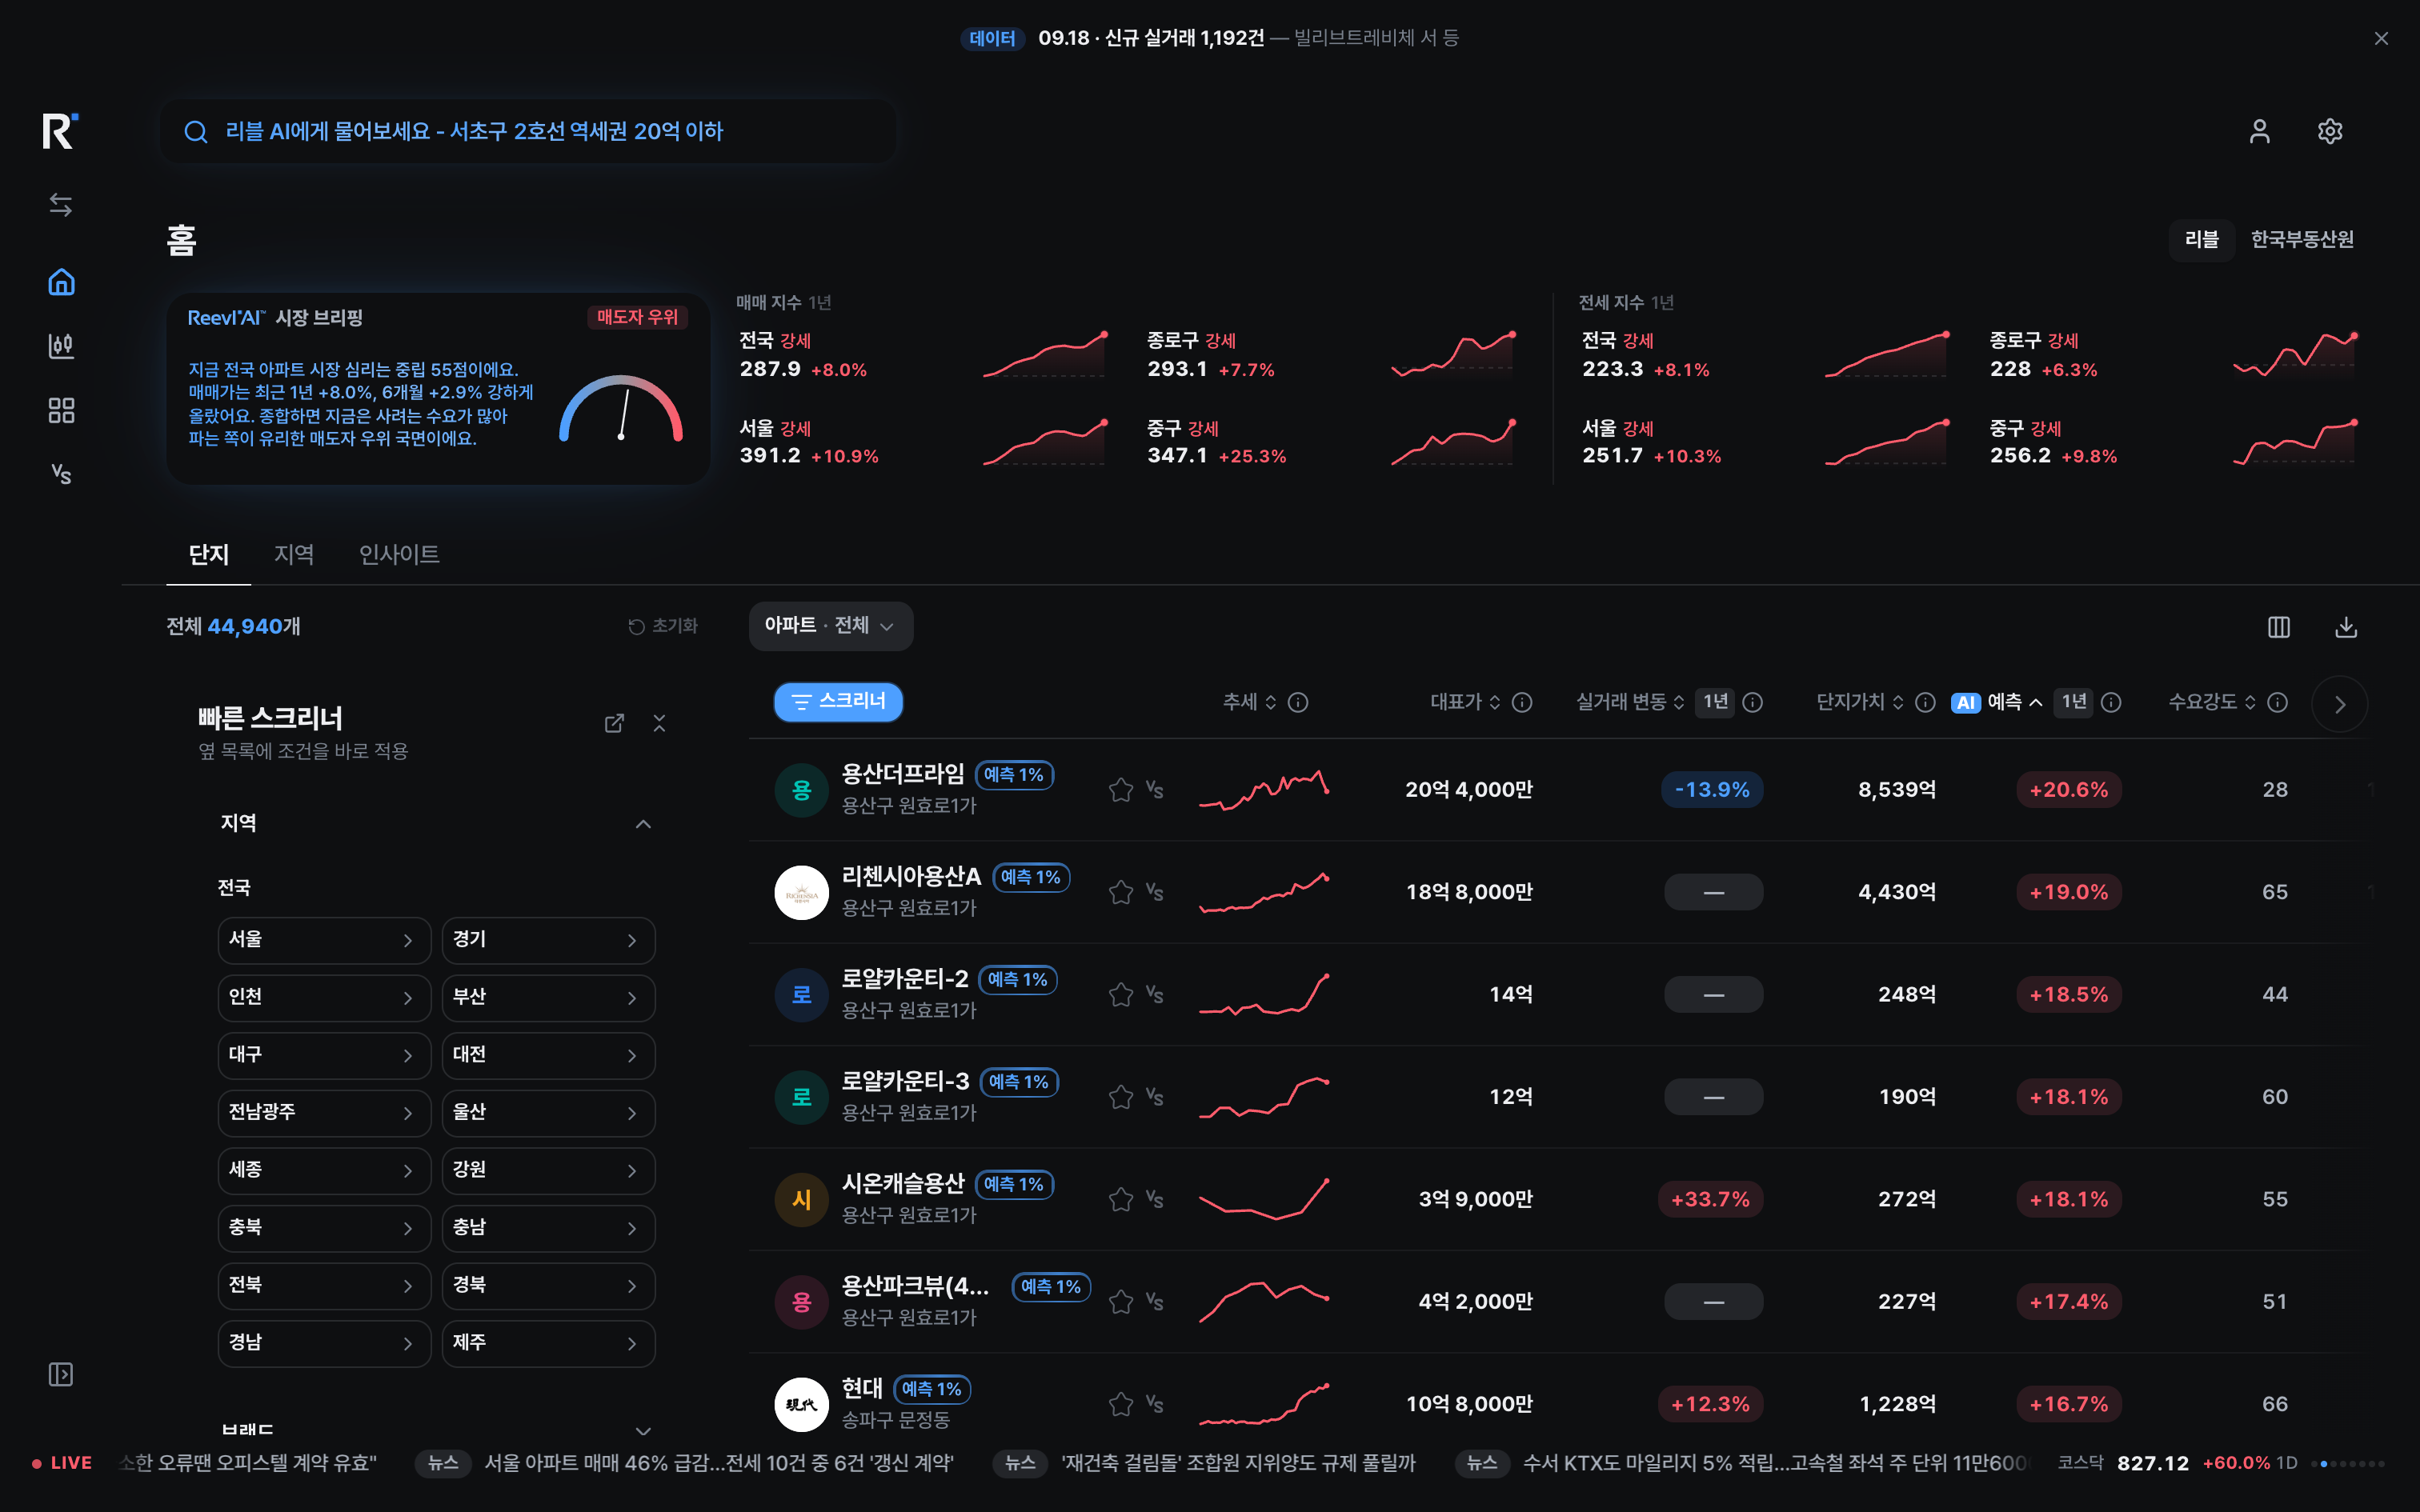
2026년 8월 27일, Reevl에 기능 12종을 하루에 공개했다. 각 기능은 리뷰를 통과했다. 몇 시간 만에 이탈률이 24%에서 62%로 올랐고, 체류 시간은 226초에서 40초로 떨어졌다. RageClick 36건이 찍혔는데 관측 기간 중 그날뿐이었다(GA4 · Clarity 실측).
세션 리플레이를 하나씩 봤다. 기능이 아니라 화면이 문제였다. 눌릴 것처럼 생겼는데 안 눌리는 요소, 누르면 보던 화면이 초기화되는 필터, 읽는 순서 없이 늘어난 정보. 원인 6개를 찾아 고쳤다.
8월 29일 RageClick 0건, DeadClick은 98건에서 18건. 9월 1일 이탈률 29%, 체류 115초로 돌아왔다(실측).
- 반박된 것 – 리뷰를 통과한 화면은 괜찮다는 가정. 기능 12종은 각각 맞았고, 한 화면에 함께 놓인 결과가 틀렸다.
- 바꾼 것 – 리뷰는 "좋아 보이나"까지만 답한다. 그래서 출시할 때 내 판단을 반박할 수 있는 지표를 같이 켠다.
02. 맞히지 못하는 숫자는 정밀하게 보여 주지 않는다
Reevl의 1년 전망은 단지 순위 적중도(IC)가 0.19였고 분기의 93%에서 양수였다. 2년 이상은 단지 단위 IC가 0.01이었다. 사실상 맞히지 못하는 숫자다.
금액을 원 단위로 찍으면 아래에 무슨 주석을 달아도 확신으로 읽힌다. 그래서 장기 예측은 금액을 표시하지 않는다. 워크포워드 검증을 통과한 지역 단위(IC 0.16)로만 보여 준다.
검증 성적 자체도 한 번 나를 속였다. 라벨 계산에 미래 정보가 새어 들어가 IC가 두 배로 부풀었다. FEATURE_LAG=2로 고쳤다. 모델 업그레이드 5종 중 4종은 실측 뒤 기각했다.
- 반박된 것 – 좋아 보이는 검증 성적은 믿어도 된다는 가정.
- 바꾼 것 – 정밀도는 시각적 주장이다. 데이터가 받치지 못하면 화면이 주장하지 않게 했다.
03. 모르는 금액은 추정하지 않고 비운다
Commit의 공고 API에는 지원금액이 없다. 금액은 별도의 사업정보 API에만 있다. 그래서 매칭이 확실한 공고에만 금액을 표시한다. 11,757건 중 2,595건, 22.1%다(산출물).
빈칸을 모델로 채우면 커버리지는 오르고 신뢰는 떨어진다. 틀린 금액 하나가 맞는 금액 여러 개보다 신뢰를 더 깎는다고 봤다. 규칙이 확신하지 못하면 숫자를 비우고 원문으로 보낸다. 런타임 LLM 호출은 아예 없다. 공고 요약과 자격 진단도 규칙 기반이다.
같은 판단을 로고에도 적용했다. 파비콘 서비스가 빈 아이콘을 '성공'으로 돌려줬다. 그래서 손으로 확인한 기관 116곳의 로고만 쓴다.
- 반박된 것 – 자동화가 성공을 보고하면 결과도 맞다는 가정.
- 바꾼 것 – 기본값을 넣는 것도 하나의 주장이다. 모르면 비운다.
04. 상승은 빨강, 하락은 파랑으로 고정했다
해외에서는 초록이 상승이다. 한국 시장을 보는 사람은 빨강을 상승으로 읽는다. 여기서는 빨강이 맞다.
관습은 꾸밈이 아니라 정보다. 화면마다 알아서 하게 두면 언젠가 어긋난다. 그래서 등락 색은 디자인 토큰(up · down)으로만 존재하고, 제품 어디에서도 초록은 상승을 뜻하지 않는다.
토큰은 코드에서 역으로 뽑아 Figma 라이브러리로 다시 만들었다. 변수 140개 · 스타일 28개 · 컴포넌트 23개다(v1.0, 2026년 9월 17일 · 산출물). 지켜지는 정도는 빌드마다 잰다. 색 98.5% · 타이포 100% · z층 95.2%(ds_scan 실측).
- 반박된 것 – 일관성은 지키려고 애쓰면 지켜진다는 가정.
- 바꾼 것 – 규칙을 어길 수 없는 자리에 뒀다.
05. 멀쩡해 보였지만 기준 미달이던 색 두 개
SAI에서 보조 글자는 4.49:1, 강조색 위 흰 글자는 3.88:1이었다. 둘 다 WCAG AA 미달인데 내 눈에는 멀쩡해 보였다. 5.05와 4.77로 고쳤다(실측).
그래서 눈으로 보는 대신 검사를 걸었다. Playwright 테스트 32개를 데스크톱(1440×900)과 모바일에서 돌린다. 콘솔 오류가 하나라도 나면 실패로 처리하고, axe로 WCAG 2.1 AA를 확인한다(산출물).
- 반박된 것 – 화면에서 멀쩡해 보이면 기준을 넘는다는 가정.
- 바꾼 것 – 잴 수 있는 것은 재서 정한다. 눈은 두 번째 의견이다.
06. 기능 순서가 아니라 필요한 순간 순서로
KTX 정보 표시의 객실 화면은 기능 단위로 나뉘었다. 다음 역, 도착 시각, 환승, 편의시설, 안내 문구가 같은 무게로 놓였다. 승객은 필요한 것을 매번 찾아야 했다.
필요한 순간을 기준으로 다시 짰다. 탑승 전, 이동 중, 도착 후. 다음 역과 도착 시각, 운행 상태는 객실 반대편에서도 읽히는 크기로 두고 나머지는 뒤로 물렸다. 문이 열릴 때는 어느 쪽 문인지만 크게 띄웠다. 한국어와 영어는 같은 레이아웃 체계를 쓴다. 역 이름의 네 가지 표기도 같은 규칙으로 놓았다.
정보를 더하지 않았다. 순서만 정했다.
- 아직 확인하지 못한 것 – 실제 차량의 시야 거리와 조도, 승객 대상 검증. 사용성이 좋아졌다는 숫자는 없다.
AI가 만든 결과를 판단할 때
매일 AI와 함께 코드를 쓰고, AI가 만든 내용이 들어가는 제품을 운영한다. 같은 질문을 여기에도 적용한다.
- 생성이 아니라 체계가 결정한다. 생성된 화면이 Reevl의 토큰 밖으로 나가면 화면이 아니라 토큰을 고쳤다.
- 틀릴 수 있는 자리에는 두지 않는다. Commit은 런타임에 모델을 부르지 않는다. 틀릴 자리를 만들지 않는 편이 틀린 답을 고치는 것보다 쌌다.
- 생성된 제안에는 근거를 붙인다. SAI의 제안 카드에는 출처가 된 발화가 붙고, 사람이 수락하기 전에는 노트가 되지 않는다.
- 로그가 아니라 결과물을 본다. 내 파이프라인이 6주 동안 성공을 보고하는 사이 네이버 블로그 발행은 멈춰 있었다. 감시 필터의 오류로 서버 에러 11,891건이 0건으로 보고됐다. 지금은 발행된 결과물을 감시한다.
화면을 볼 때 던지는 네 가지 질문
- 이 화면에서 할 일이 뭔가. 사용자가 하러 온 일을 한 문장으로 말해 보고, 그게 제일 쉽게 되는지 본다.
- 무엇이 제일 크게 보이나. 크기와 굵기와 위치는 전부 중요도를 말한다. 다 같은 크기면 아무 말도 하지 않는 셈이다.
- 색에 뜻이 있나. 상승과 하락, 정상과 지연을 가리키는지 아니면 꾸밈인지.
- 잴 수 있는 게 뭔가. 명도 대비, 초점 순서, RageClick, 체류 시간, 적중도. 잴 수 있으면 취향으로 다투지 않는다.
아직 모르는 것
여섯 개 모두 내가 만든 제품에서 나왔다. Reevl과 Commit은 1인 제품이고, SAI는 3인 팀에서 내 몫이 UX와 디자인 시스템, 프론트엔드였다. 남의 화면을 두고도 같은 판단이 나오는지는 아직 보여 줄 재료가 없다.